Содержание
Как арендовать сервер для AI: пошаговая инструкция от выбора GPU до запуска модели
Запуск Llama 3 70B в 16-битной точности требует около 140 ГБ видеопамяти. Ни одна потребительская видеокарта столько не даёт, а покупка серверной H100 обойдётся в сумму от 25 000 долларов. Поэтому команды, которые тестируют ML-гипотезы, идут в облако: аренда vds сервера с графическим ускорителем стоит сотни рублей в час, а обновлять железо будет провайдер. Разберём путь от выбора карты до первого инференса без лишних трат.
Что такое сервер для AI и чем он отличается от обычного VDS
Сервер для AI — это виртуальная или выделенная машина с графическим ускорителем, на котором выполняются матричные операции нейросетей. Аренда означает доступ к такой машине по SSH на нужный срок, а провайдер отвечает за питание, охлаждение и замену сгоревших карт.
Обычный VDS считает на процессоре, и для инференса этого мало. Тест простой: BERT-base на 8 ядрах CPU обрабатывает порядка 20 запросов в секунду, а на одной T4 — около 400. Разница в 20 раз при похожей цене часа. Для обучения пропасть ещё шире.
Второе отличие — формат оплаты. GPU-инстансы тарифицируются почасово, потому что типичная задача длится от пары часов до нескольких недель. Прогнали эксперимент, сняли веса, выключили машину. Помесячная оплата оправдана только для круглосуточного инференса.
Наконец, у GPU-машин свои требования к софту. Драйвер NVIDIA, CUDA, cuDNN и фреймворк должны совпадать по версиям, иначе PyTorch не увидит карту. Провайдеры вроде «МЛ Клауд» дают образы с уже собранным стеком, что экономит первые два-три часа.

Как выбрать GPU под задачу
Правило простое: считайте объём видеопамяти, а не производительность в TFLOPS. Модель, которая не влезла в VRAM, не запустится вовсе, а медленная карта хотя бы досчитает.
Прикинуть потребность можно по числу параметров. В формате FP16 каждый параметр занимает 2 байта, поэтому модель на 7 миллиардов весов требует 14 ГБ плюс 20-30 % на активации и KV-кэш. Квантование в 4 бита сжимает веса примерно вчетверо: та же Llama 3 8B уместится в 6 ГБ. Для дообучения умножайте цифру на три-четыре из-за градиентов и состояний оптимизатора.
Дальше смотрите на класс карты. Под инференс и эксперименты хватит RTX 4090 или A10 с 24 ГБ; под обучение больших моделей нужны A100 либо H100 с 80 ГБ HBM3 и скоростью памяти 3,35 ТБ/с. Час H100 дороже часа 4090 в 5-8 раз, переплачивать без расчёта нет смысла.
Перед заказом сверьтесь с коротким чек-листом:
- объём VRAM с запасом 20 % над расчётной потребностью;
- поддержка нужного формата чисел (BF16 есть только на Ampere и новее);
- количество карт и тип связи между ними, NVLink или PCIe;
- версия драйвера, которую провайдер ставит по умолчанию.
Сколько нужно оперативной памяти, диска и сети
Ориентир по RAM: не меньше удвоенного объёма VRAM. При загрузке весов из safetensors они сначала попадают в оперативку, и на карте с 80 ГБ сервер с 64 ГБ RAM начнёт свопить или упадёт по OOM.
Диск выбирайте NVMe. Датасет ImageNet весит 150 ГБ, а веса Llama 3 70B — те самые 140 ГБ, и читать их с SATA SSD на 550 МБ/с придётся четыре с лишним минуты при каждом перезапуске. NVMe PCIe 4.0 отдаёт до 7 ГБ/с, то есть тот же чекпоинт поднимется за 20-25 секунд.
Сеть важна в двух сценариях. Первый — скачивание моделей с Hugging Face: при канале 100 Мбит/с 140 ГБ будут идти больше трёх часов, при 1 Гбит/с — около 20 минут. Второй — распределённое обучение, где узлы с каналом ниже 25 Гбит/с в основном ждут синхронизации градиентов.
Мини-кейс из практики. Команда компьютерного зрения взяла A100 с 32 ГБ RAM и HDD и жаловалась на утилизацию GPU в 30 %. Профилировщик показал, что загрузчик данных не успевает читать картинки с диска. Переезд на NVMe и расширение RAM до 128 ГБ подняли утилизацию до 90 % без единой строчки кода.
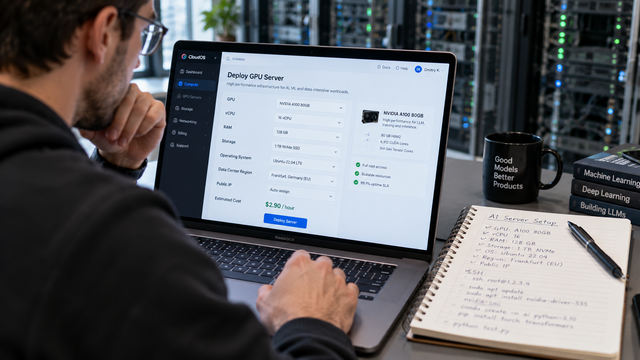
Как подготовить окружение: драйверы, CUDA и контейнеры
Базовый порядок один: драйвер, затем CUDA, затем фреймворк в изолированном окружении. Нарушение очерёдности и есть причина большинства вопросов «почему torch.cuda.is_available() возвращает False».
Вот последовательность шагов на чистой Ubuntu 22.04:
- Установите драйвер командой apt install nvidia-driver-550 и перезагрузитесь.
- Проверьте nvidia-smi: в шапке должны отобразиться карта и версия драйвера.
- Поставьте Docker и NVIDIA Container Toolkit, чтобы контейнеры видели GPU.
- Запустите образ pytorch/pytorch с нужным тегом CUDA и проверьте карту из Python.
Контейнеры вместо установки на хост — не прихоть, а страховка. Обновление драйвера ломает системный CUDA, а внутри образа версии зафиксированы. В NGC-каталоге NVIDIA есть готовые образы с PyTorch, TensorFlow и Triton.
Отдельно позаботьтесь о доступе. Заходите по SSH-ключам и откройте только порты 22 и 8000. Серверы с открытым Jupyter без пароля сканеры находят за часы, после чего карта майнит чужую криптовалюту. Если собирать стек руками не хочется, у «МЛ Клауд» есть машины с предустановленными драйверами и Docker.
Как запустить модель и проверить, что всё работает
Быстрее всего первый инференс даёт готовый сервер вроде vLLM или Ollama: одна команда, и модель отвечает по HTTP. Свой цикл генерации на голом transformers нужен только для нестандартных задач.
Для продакшен-нагрузки берите vLLM. Благодаря PagedAttention он обслуживает десятки запросов одновременно и, по данным авторов, даёт в 10-20 раз больше пропускной способности, чем последовательная генерация. Команда vllm serve meta-llama/Meta-Llama-3-8B-Instruct поднимает OpenAI-совместимый API на порту 8000.
Первый же запрос покажет, правильно ли подобрано железо. Откройте nvidia-smi во втором терминале. Если память под 95 %, а загрузка ядра скачет от 0 до 100, не хватает VRAM под KV-кэш: уменьшите max-model-len или включите квантование. Стабильные 70-90 % при ответе за секунду-две означают, что всё настроено верно.
Пример: стартап поднял Llama 3 8B на RTX 4090 и получил 35 токенов в секунду для одного пользователя. После перехода на vLLM с батчингом при 20 параллельных сессиях суммарная скорость выросла до 600 токенов в секунду. Сомневаетесь в конфигурации? Попросите у «МЛ Клауд» тестовый доступ на пару часов и прогоните реальный сценарий.
